Загружать файлы Excel на основе выбранной даты файла
У меня есть три файла Excel с разными датами в именах файлов, хранящихся в папке.
Путь к папке: D:\SourceFolder\
Имена файлов: Asia_Sale_07May2018.xlsx , Asia_Sale_20Jun2018.xlsx , Asia_Sale_15Aug2018.xlsx
У меня есть дата параметра пакета 07/15/2018 .
Требование: обрабатывать файлы, в которых дата имени файла = дата параметра.
Если я установил для параметра date значение 07/15/2018 , пакет должен выбрать и загрузить Asia_Sale_15Aug2018.xlsx
Если я установил для параметра date значение 06/20/2018 , пакет должен выбрать и загрузить Asia_Sale_20Jun2018.xlsx
Если я установил для параметра date значение 05/07/2018 , пакет должен выбрать и загрузить Asia_Sale_07May2018.xlsx
2 ответа
1. Прокрутите файлы с помощью цикла ForEach Loop и получите FileName и используйте Substring, чтобы получить только часть даты (07May2018 / 20Jun2018 / 15Aug2018 в вашем случае). Преобразуйте это в нужный формат с помощью функции преобразования.
2. Используйте ограничение приоритета в потоке управления, которое сравнивает оба значения и загружает файл, если он совпадает.
Я бы создал имя файла, который вы ищете, и использовал бы цикл foreach для поиска этого конкретного файла.
Логика C # для этого:
Как только вы его получите, используйте свою переменную, чтобы проверить цикл foreach для файла.
SQL Server Integration Services (SSIS) для начинающих – часть 3
В этой части я расскажу о работе с параметрами и переменными внутри SSIS-пакета. Узнаем, как можно задавать и отслеживать значения переменных во время выполнения пакета.
Также рассмотрим вызов одного пакета из другого при помощи «Execute Package Task» и некоторые дополнительные компоненты и решения.
Здесь тоже будет много картинок.
Продолжим знакомство с SSIS
Создадим в трех демонстрационных базах новую таблицу ProductResidues, которая будет содержать информацию об остатках на каждый день:
И наполним таблицы в источниках тестовыми данными, поочередно выполнив на базах DemoSSIS_SourceA и DemoSSIS_SourceB следующий скрипт:
Допустим, что в таблице ProductResidues будет очень много строк, и чтобы каждый раз не перезагружать всю информацию и упростить процедуру интеграции, логику загрузки в таблицу ProductResidues в базе DemoSSIS_Target реализуем следующую:
- Если в принимающей БД еще нет записей, то загрузим все данные;
- Если в принимающей БД есть данные, то будем удалять данные за неделю (последние 7 дней) от последней загруженной даты и загружать данные из источника начиная от этой даты снова.
В нашем же случае еще допустим, что пользователи могут менять данные задним числом и могут вообще удалить некоторые ранее загруженные в базу DemoSSIS_Target строки из источников. Поэтому здесь обновление делается как-бы внахлёст, данные последней недели полностью перезаписываются. Здесь неделя берется условно, об этом минимальном сроке, например, мы могли бы условиться с заказчиком (он мог подтвердить, что данные обычно меняются максимум в течении недели). Конечно это не самый надежный способ, и иногда могут возникнуть расхождения, например, в том случае, когда пользователь поменял данные месячной давности и здесь стоит предусмотреть возможность перезагрузки данных начиная с более ранней даты, мы сделаем это при помощи параметра, в котором будем указывать нужное нам количество дней назад.
Создадим новый SSIS-пакет и назовем его «LoadResidues.dtsx».
При помощи контекстного меню, отобразим область ввода переменных пакета (это можно сделать также при помощи меню «SSIS → Variables»):

В данном пакете, нажав на кнопку «Add Variable», создадим переменную LoadFromDate типа DateTime:

По умолчанию переменной присваивается текущее значение даты/времени, т.к. мы будем переопределять значение внутри пакета, нам это не важно.
Значения переменных можно задавать при помощи компонента «Expression Task». Давайте рассмотрим, как это делается. Создадим элемент «Expression Task»:

Двойным щелчком откроем редактор данного элемента:

Пропишем следующее выражение:
Здесь так же была применена двойная конвертация типа, чтобы избавиться от составляющей времени и оставить только дату.
Давайте так же посмотрим как можно отследить значение переменной во время выполнения пакета.
Создадим точку останова на элементе «Expression Task»:
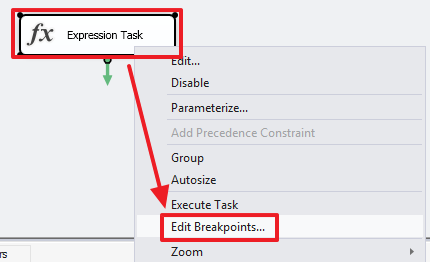
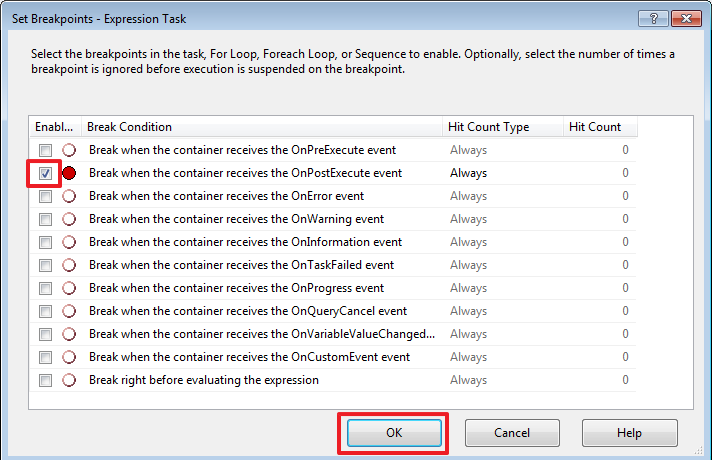
Укажем, что точка должна срабатывать по окончанию выполнения данного блока:
Запустим пакет на выполнение (F5) и после остановке в нашей точке, перейдем на вкладку «Locals»:
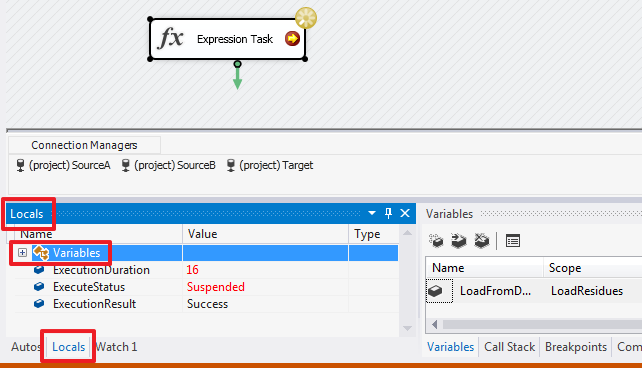
Раскроем список Variables и найдем в нем свою переменную:

Для интереса можем поменять выражение элементе «Expression Task» на следующее:
и также поэкспериментировать:

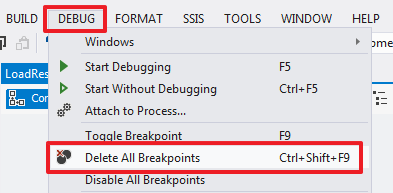
Точку останова убирается таким же образом каким и была установлена. Либо можно удалить сразу все точки останова, если их было несколько:
Создадим параметр, который будет отвечать за количество дней назад.
Параметр можно создать, как глобальный для всего проекта:

Так и локальный, внутри конкретного пакета:

Параметр может быть обязательный для задания – за это отвечает флаг Required. Если этот флаг установлен, то при создании задачи или при вызове пакета из другого пакета нужно будет определить входящее значение параметра (мы рассмотрим это далее).
Сохраним параметры и снова зайдем в редактор «Expression Task»:
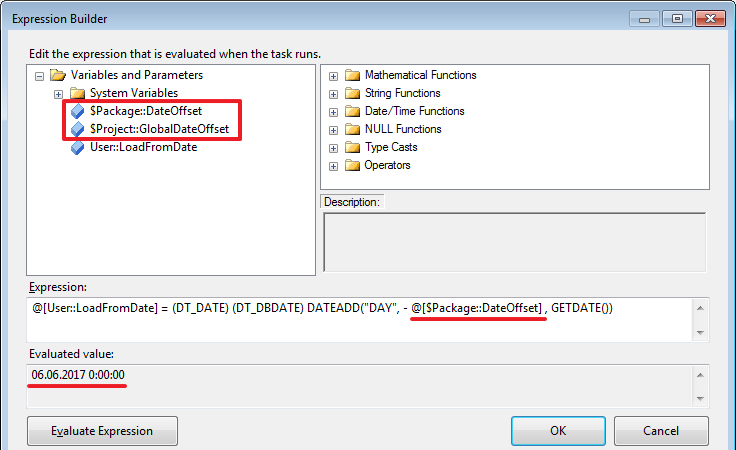
Для примера я поменял выражение на следующее:
Думаю, на этом суть параметров и переменных ясна, и мы можем продолжить.
После того как мы поигрались с «Expression Task» мы его удалим.
Создадим «Execute SQL Task»:

Настроим его следующим образом:

Пропишем в SQLStatement следующий запрос:
Т.к. данный запрос возвращает одну строку, установим ResultSet = «Single Row» и ниже на вкладке «Result Set» сохраним результат в значение переменной LoadFromDate.
На вкладке «Parameter Mapping» зададим значения параметров, которые в запросе обозначены знаком вопроса (?):

Параметры нумеруются, начиная с нуля.
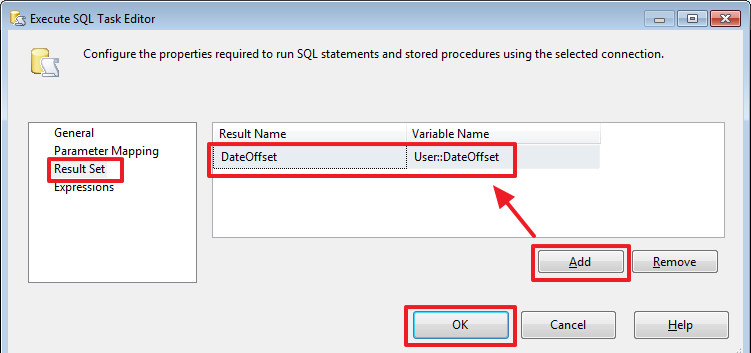
Теперь на вкладке «Result Set» укажем в какую переменную нужно записать результат выполнения запроса:
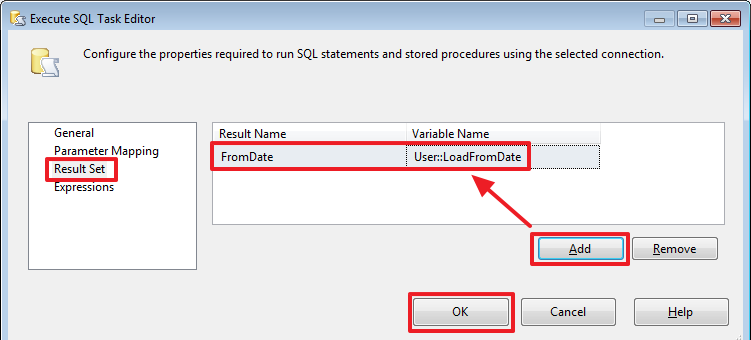
Здесь так же можем продебажить установив у этого компонента точку останова на «Break when the container receives the OnPostExecute event» и запустив пакет на выполнение:

Здесь я для удобства мониторинга значения переменной прописал название переменной в «Watch», чтобы не искать ее в блоке «Locals».
Как видим все верно в переменную LoadFromDate записалась дата «01.01.1900», т.к. строк в таблице ProductResidues на Target еще нет.
Переименую для наглядности «Execute SQL Task» в «Set LoadFromDate».
Создадим еще один элемент «Execute SQL Task» и назовем его «Delete Old Rows»:

Настроим его следующим образом:

SQLStatement содержит следующий запрос:
И зададим значение параметра на вкладке «Parameters Mapping»:
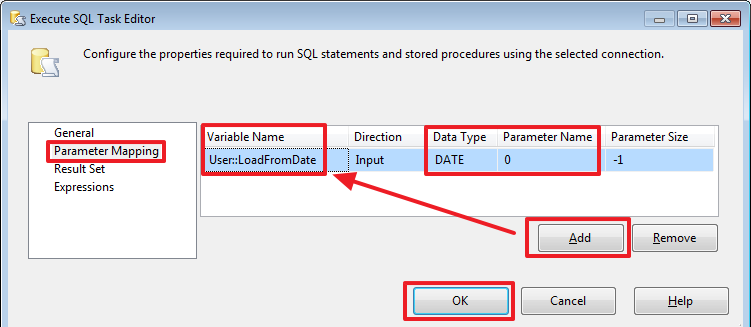
Все, удаление старых данных за указанный конечный период у нас реализовано.
Теперь сделаем часть отвечающую загрузку свежих данных. Для этого воспользуемся компонентом «Data Flow Task»:
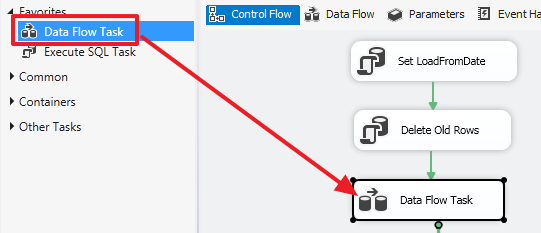
Зайдем в область данного компонента и создадим «Source Assistant»:

Настроим его следующим образом:

Нажав на кнопку «Parameters…» зададим значение параметра:

Для записи новых данных воспользуемся уже знакомым компонентом «Destination Assistant»:

Протянем стрелку от «Source Assistant» и настроим его:

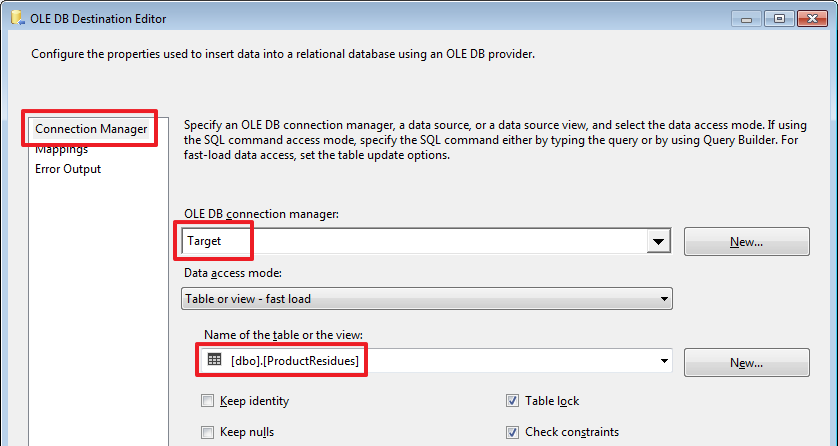

Все, пакет для переноса данных с источника SourceA у нас готов, можем запустить его на выполнение:

Запустим еще раз:

Как видим при повторном запуске удалились и залились только данные за указанный период. Ну вроде все работает так как мы и хотели. На всякий случай сверимся, что данные получателя по количеству равны данным источника:

Дойдя до сюда, я понял, что я допустил ошибку. Кто понял в чем дело, молодец!
Но может это и хорошо, т.к. пример получился не таким перегруженным.
Ошибка в том, что я забыл учесть, что при интеграции данных таблицы Products у нас в Target формируются свои идентификаторы (поле ID с флагом IDENTITY)!
Давайте переделаем, чтобы все было правильно. Ничего страшного повторим, зато лучше запомним.
Забежим чуть вперед и добавим в пакет еще один параметр, который назовем «SourceID»: 
Перенастроим «Set LoadFromDate»:

В SQLStatement пропишем новый запрос с учетом SourceID:
Настроим второй параметр:
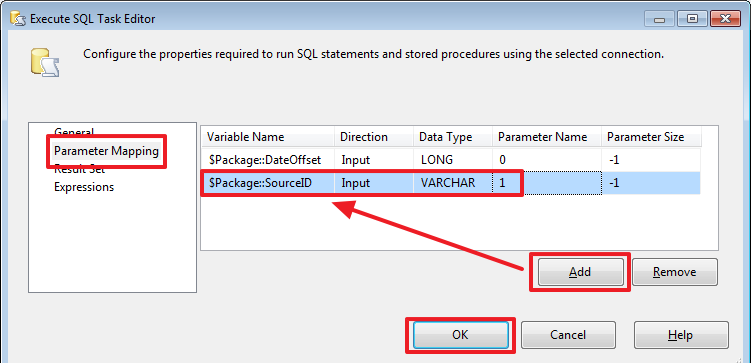
Теперь перенастроим «Delete Old Rows» аналогичным образом, чтобы учитывался SourceID:

В SQLStatement пропишем новый запрос с учетов SourceID:
Настроим второй параметр:
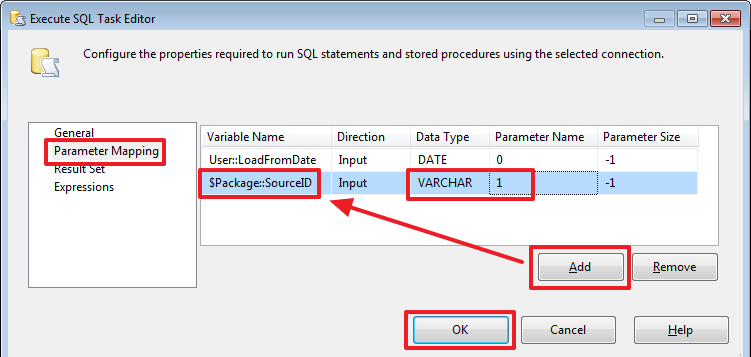
Теперь зайдем в «Data Flow Task», удалим цепочку и добавим «Derived Column»:

Настроим его следующим образом:

Здесь я намеренно оставил тип «Unicode string», а не сделал преобразование как в первой части. Давайте за одно рассмотрим компонент «Data Conversion»:

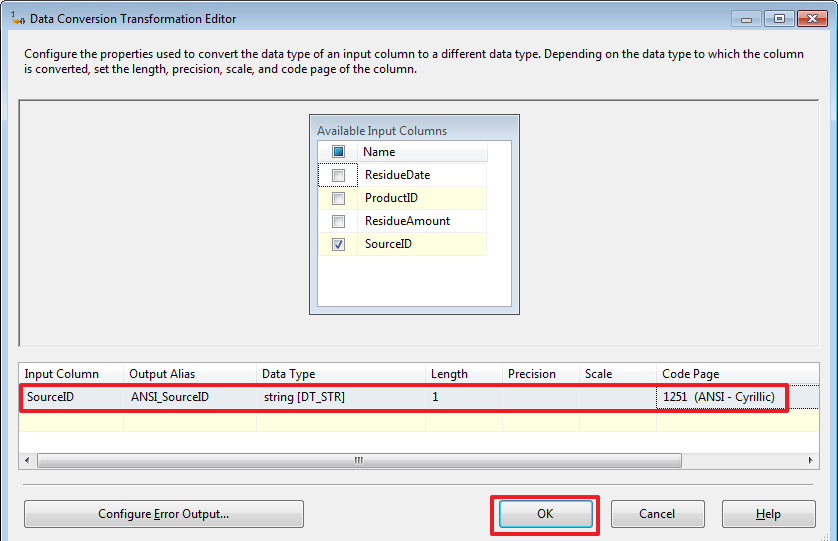
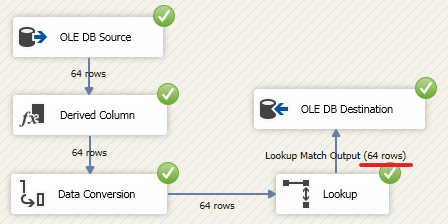
Теперь при помощи Lookup сделаем сопоставление и получим нужные нам идентификаторы продуктов:


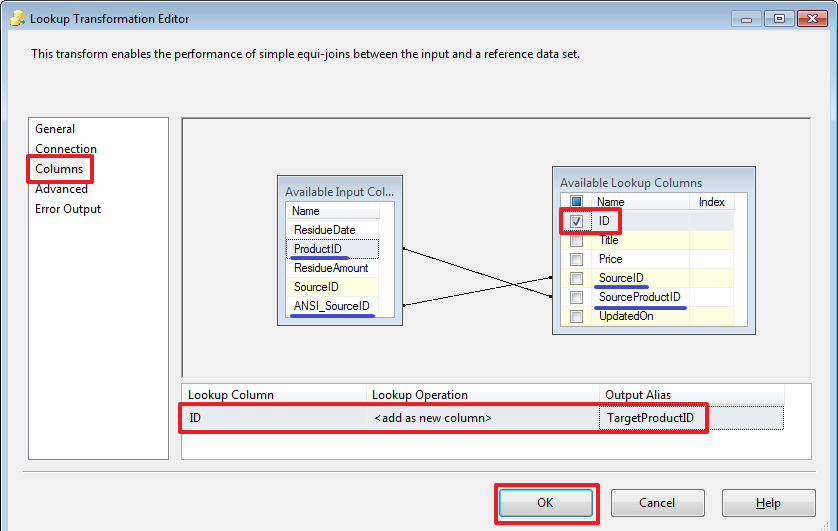
Теперь протянем синюю стрелку от Lookup к «OLE DB Destination»:
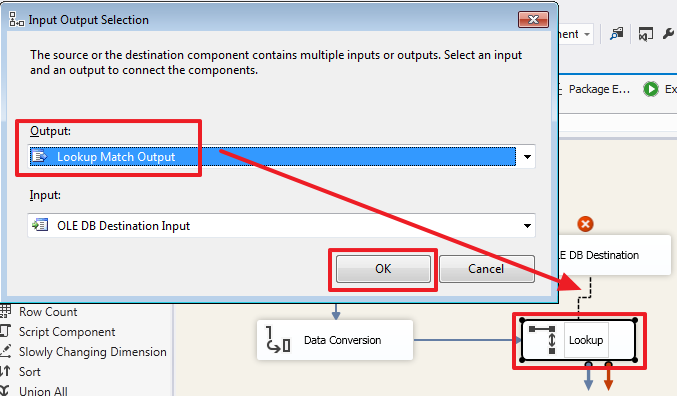
Выберем поток «Lookup Match Output»:

Настроим «OLE DB Destination», нужно перестроить Mappings:
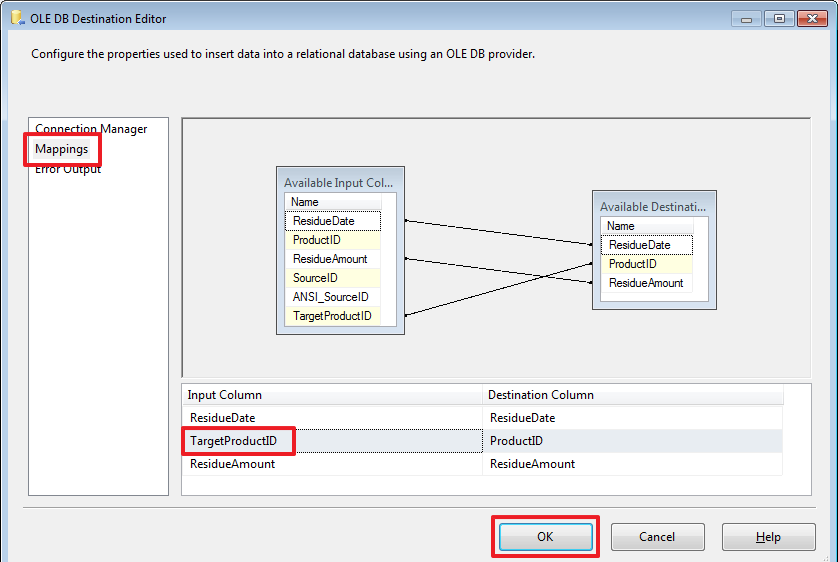
Все, сделаем очистку таблицы от неправильно загруженных данных:
И запустим пакет на выполнение:


Похоже на правду. Можете самостоятельно проверить правильно ли разнеслись идентификаторы продуктов.
Так как структура DemoSSIS_SourceA и DemoSSIS_SourceB одинакова и нам нужно сделать для DemoSSIS_SourceB, то же самое, то мы можем при создании задачи создать два шага для пакета «LoadResidues.dtsx», в первом шаге настроить подключение к базе DemoSSIS_SourceA, а на втором шаге DemoSSIS_SourceB.
Откомпилируем и передеплоим SSIS проект:


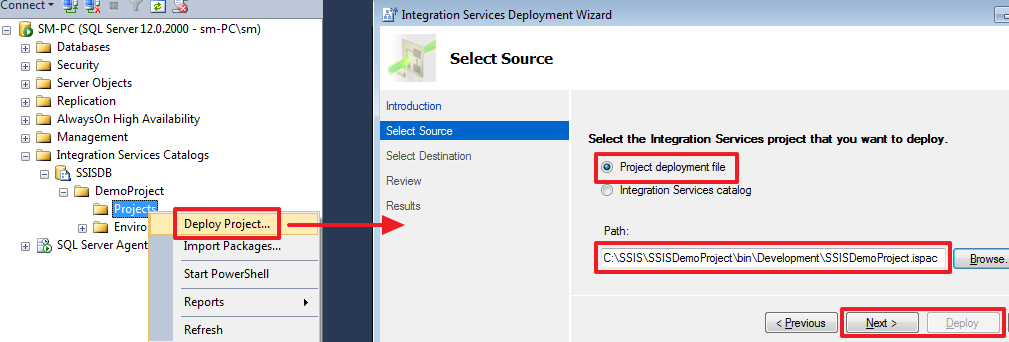
Давайте теперь создадим новое задание в SQL Agent:

На вкладке Steps создадим шаг 1 для загрузки продуктов:

Создадим шаг 2 для загрузки остатков из SourceA:
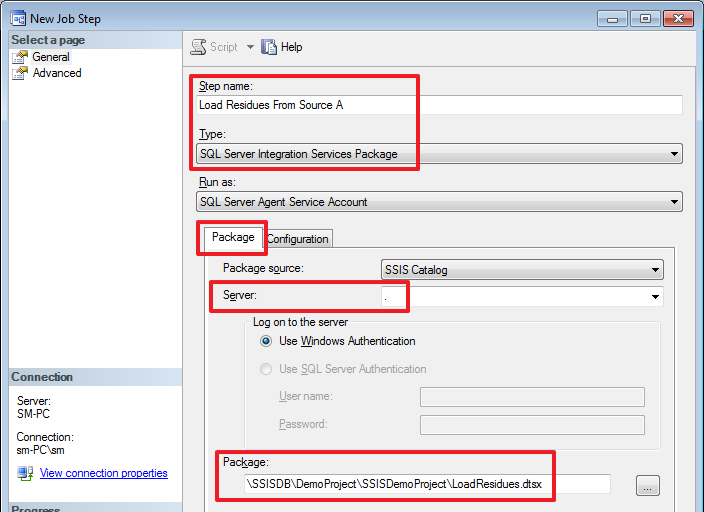
На вкладке Configuration можем увидеть наши параметры:

Здесь от нас требуют ввести SourceID, т.к. мы указали его как Required. Зададим его:

Данные вкладки «Connection Managers» изменять для этого шаге не будем.
Создадим шаг 3 для загрузки остатков из SourceB:

Зададим параметр SourceID:

И изменим данные соединения SourceA таким образом, чтобы оно ссылалось на базу DemoSSIS_SourceB:

В данном случае мне достаточно было изменить ConnectionString и InitialCatalog, теперь они указывают на DemoSSIS_SourceB.
В итоге мы должны получить следующее – три шага:
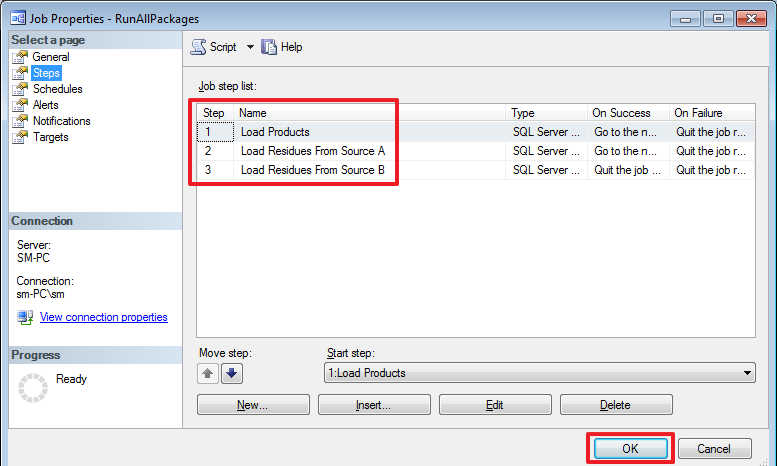
Запустим эту задачу на выполнение:

И убедимся, что все отработало как надо:

Теперь допустим, что базы DemoSSIS_SourceA и DemoSSIS_SourceB расположены на одном экземпляре SQL Server. Давайте переделаем «OLE DB Source»:


Теперь наш пакет в зависимости от значения параметра SourceID будет брать данные либо из SourceA, либо из SourceB.
Для теста можете изменить значение параметра SourceB на «B» и запустить проект на выполнение:

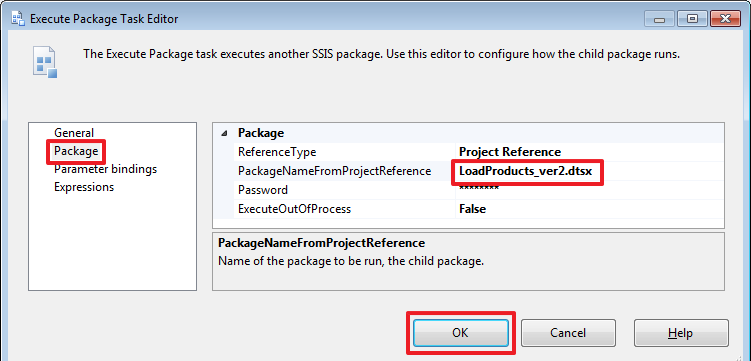
Давайте теперь создадим новый пакет «LoadAll.dtsx» и создадим в нем «Execute Package Task» (переименуем его в «Load Products»):

Настроим «Load Products»:
Создадим в новом пакете 2 параметра:

В области «Control Flow» создадим еще 2 компонента «Execute Package Task» которые назовем «Load Resudues A» и «Load Resudues B»:
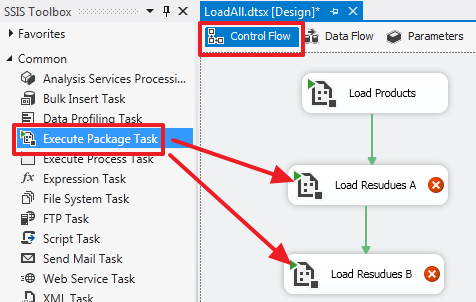
Настроим их задав у обоих название пакета «LoadResidues.dtsx»:

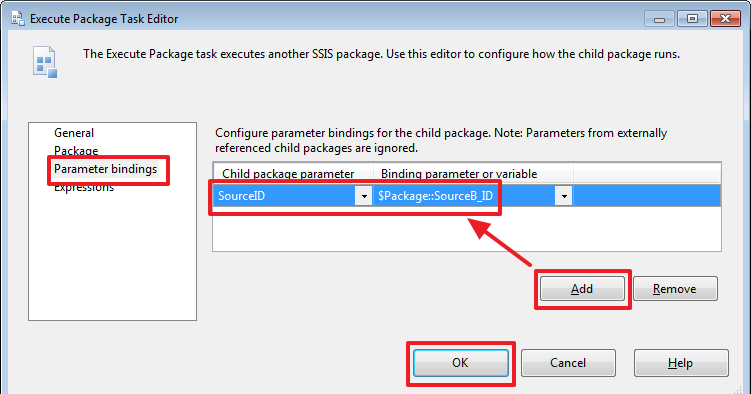
Зададим обязательный параметр SourceID для «Load Resudues A»:

Зададим обязательный параметр SourceID для «Load Resudues B»:
Обратите внимание, что у стрелок тоже есть свои свойства, например, мы можем поменять свойство Value на Completion, что будет означать, что следующий шаг будет выполнен даже в том случае если на шаге «Load Resudues A» произойдет ошибка:

Все, можем запустить пакет на выполнение:
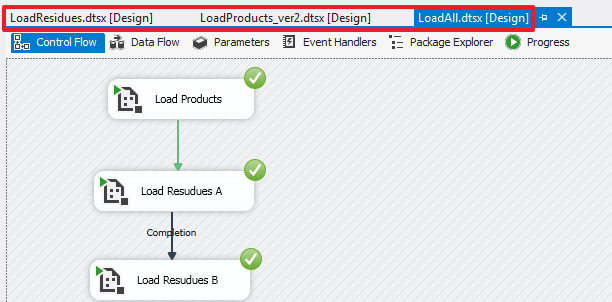
Думаю, объяснять, что здесь произошло нет смысла.
Иногда параметры для конкретного пакета удобно хранить в вспомогательной таблице и считывать их оттуда в переменные пакета, например, используя для поиска глобальную переменную «System::PackageName». Для демонстрации, давайте переделаем наш пакет таким образом.
Создадим таблицу с параметрами:
Удалим параметр DateOffset из пакета «LoadResidues.dtsx»:

Создадим в пакете переменную DateOffset:

В область «Control Flow» добавим еще один элемент «Execute SQL Task» и переименуем его «Load Params»:

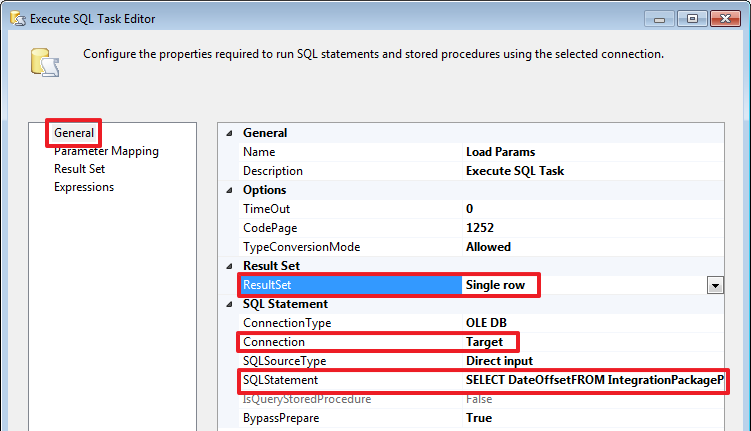
Запрос в SQLStatement пропишем следующий:
Настроим параметр запроса используя системную переменную «System::PackageName»:
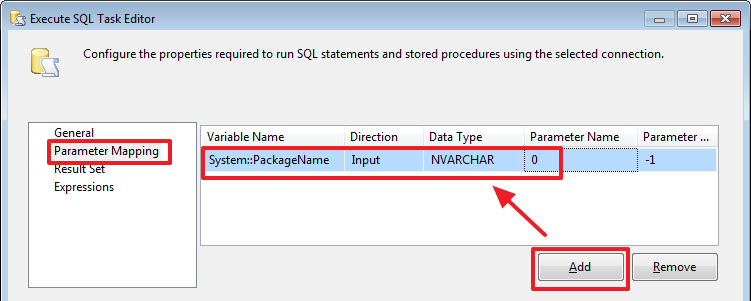
Осталось сбросить результат выполнения запроса в переменную:
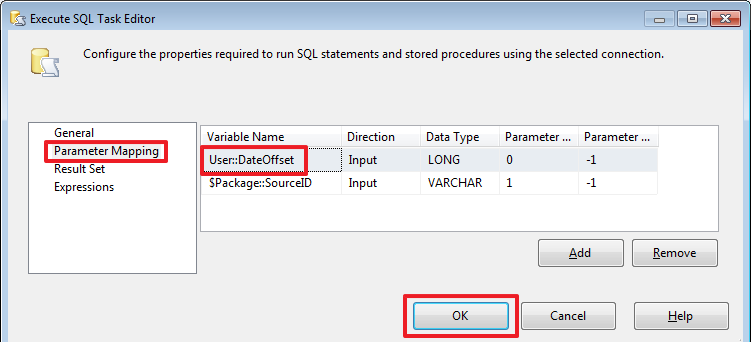
Теперь осталось перенастроить «Set LoadFromDate», чтобы в нем использовалась теперь переменная:

Все, можем тестировать новую версию пакета.
Вот мы и добрались до финиша. Мои поздравления!
Заключение по третьей части
Уважаемые читатели, эта часть будет заключительной.
В данном цикле статей, я постарался продумать примеры таким образом, чтобы сделать их как можно короче и в свою очередь охватить как можно больше полезных и важных деталей.
Думаю, освоив это, далее вы уже без особого труда сможете освоить работу с остальными компонентами SSIS. В данных статьях я рассмотрел только самые важные компоненты (наиболее часто применяемые на моей практике), но зная только это вы уже можно сделать очень многое. По мере надобности изучайте самостоятельно другие компоненты, в первую очередь порекомендовал бы посмотреть следующее:
- компоненты-контейнеры (Sequence Container, For Loop Container, Foreach Loop Container);
- «Merge Join», который позволяет сделать операции JOIN, LEFT JOIN, FULL JOIN на стороне SSIS (это требует предварительно отсортировать два набора при помощи «Sort»);
- «Conditional Split», который позволяет разбить один поток на несколько в зависимости от условий;
- так же рассмотрите вкладку «Event Handlers», которая позволяет создать дополнительные области для определенного вида события пакета.
Я не старался сделать подробный учебник (думаю, все это уже есть), а старался сделать такой материал, который позволит начинающим шаг за шагом создать все с самого нуля и делая все своими руками увидеть всю картину в целом, а после уже имея основу идти дальше самостоятельно. Очень надеюсь, что у меня это получилось и материал окажется полезен именно в таком ключе.
Я очень рад, что мне хватило сил осуществить задуманное и описать все так как я это хотел, даже получилось сделать большее, так как из-за допущенной в этой части ошибки возникли неожиданные повороты сюжета, но так я думаю, стало даже интересней. 😉
Sql Server SSIS package Flat File Destination file name pattern (date, time or similar)?
I’m scheduling a SSIS package for exporting data to flat file.
But i want to generate file names with some date information, such as foo_20140606.csv
4 Answers 4
With the help of expressions you can make connection dynamic.
Select your flat file connection from Connection Managers pane. In Properties pane, click on Expression(. ). Then choose ConnectionString Property from drop down list and in Expression(. ) put your expression and evaluate it.
Example expression(you need to tweak as per your requirement) —
which is giving E:\Backup\EmployeeCount_20140627.txt as value.
Please note — You need a working flat file connection so first create flat file connection whose connectionString property is then going to be replaced automatically by expression.
SSIS Create extract file with Date and Time for a filename
In last weeks posting, we created our first SSIS package which queried a database and saved the information to a file so we could send the information to a user. This week we are going to modify that same package to save the file with the date and time included in the filename.
Lets start by opening the project called etl_sample that we previously created and go to the Data Flow tab. We are going to add a new item from the SSIS Toolbox called Multicast. This allows us to split a process and go to two different processes.

Once you drag it over, connect it between the Ole DB Source and the Flat File destination like below.

Drag over another Flat File Destination from the Toolbox and attach it to the Multicast process. This creates a new destination with a red circle which means we need to do additional setup within it. I will not go through all of the tasks in setting up a new one since we did that last week, but you can reference it here.

I did make the changes below on the destination config screen. I called the file c:\temp\etl_sample_, and I made sure I selected the put column names in the first data row and press Ok.

It then puts us back to the Data Flow tab, and we no longer have a red circle by our new flat file destination.

Now we need to right click the Flat file Connection Manager 1 and click Properties.

On the bottom right where the properties are located, scroll down to the expressions property and click the ellipses on the right.

This will bring up the Expressions Editor. Select ConnectionString from the property box, and then click the ellipses in the Expression box.

We now need to create an expression to pass through to create the filename in a format that we desire. Basically we are concatenating multiple parts of a date separated by an underscore to create the filename. You can find more information about DATEPART right here, https://www.w3schools.com/sql/func_sqlserver_datepart.asp.
If you click Evaluate Expression at the bottom of the screen, you will know right away if you have the format correct. When I pressed the button, it shows the filename as c:\temp\etl_sample_02192017_14_22_16.csv.
Etl_sample_ we created on the file destination screen. 021920017 is for February 19, 2017. And the 14 is for 2pm, 22 is for minutes and 16 is for seconds: 14:22:16.
Below is the code so you do not have to type it in. Feel free to experiment with other functions. We could have made the extension DAT like the other file, but I called this one CSV to show up easier in the screenshots below. Click Ok and OK again.
“C:\\temp\\etl_sample_” + right(“0” + (DT_STR,4,1252) DatePart(“m”,getdate()),2)
+ right(“0” +(DT_STR,4,1252) DatePart(“dd”,getdate()),2)
+ (Dt_STR,4,1252) DatePart(“yyyy”, getdate()) +”_” + (dt_str,2,1252) datepart(“hh”,getdate()) +”_”
+ (dt_str,2,1252) Datepart(“mi”,getdate()) + “_”
+ (dt_str,2,1252) Datepart(“ss”,getdate()) + “.csv”

Lets run our project and see if it works. All green checkmarks, all good!

If we look in the destination directory, we see two files got created, etl_sample.dat and etl_sample_02192017_14_23_46.csv.

Opening up the files in Notepad, we see they have the same information in them.

Lets run the SSIS package again and see what happens in the directory. The file with the name etl_sample.dat got overwritten since the name is hardcoded in our first flat file destination which may be bad if we need to go back and see what was in the file on a certain date. Underneath that, we can see there are now two files with names that include the date and time it was run.
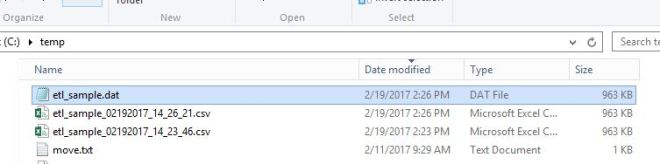
We just learned to create a flat file destination with a dynamic name that includes the date and time. This way you can run your processes multiple times in a day without overwriting previous runs, or you can use it as proof that your process actually ran.